这个刚火起来的 Codex Skill,把山西古建做成了超现实拼贴
昨天有人给我发来一条抖音图文。
双林寺的佛像被处理成黑白,背后压着很大的红蓝色块,局部还出现了尺寸完全不合理的手、鸟和器物。照片里的东西都认识,组合起来却像一本从来没见过的文化杂志。
我第一反应不是收藏图片,而是去看作者写在文案里的两个名字。
其中一个叫 `surreal-pop-collage`。
仓库刚开源几天,作品已经拿到接近 9000 个赞。它是不是只靠一套固定画风赶上了热点?还是说,里面真的有一套可以复用的方法?
我把 Skill 装进 Codex,又翻出前几天用过的三张山西古建照片,重新做了一轮。
这次不照着作者的双林寺成图复刻,也不默认使用红色太阳、蓝色天空和巨型鲸鱼。
只看这套 Skill 自己能不能把普通照片变成一张成立的作品。
它先限制你,别急着乱加东西
我读完 Skill 后,发现它最重要的并不是某个提示词。
它先给画面设了几条很死的规则。
原照片里的主体必须保留,去色以后作为现实锚点。背景可以换成两到三个巨大的平涂色形,但不能用渐变。整张图只能出现一个不可能的巨物,而且这个巨物必须能从原来的场景里找到来历。
最后一条很关键。
很多 AI 拼贴看起来热闹,细看却会发现,太阳、鲸鱼、月亮、花朵和人物只是被随手扔到了一起。画面有风格,却没有关系。
这套 Skill 反过来要求你先删。
只留一个不对劲的东西。
第一张,应县木塔和一组巨型斗拱
我先用应县木塔测试。
原图本身已经很有力量。低机位让木塔几乎占满画面,密集的斗拱和层层出檐,是最明显的识别特征。
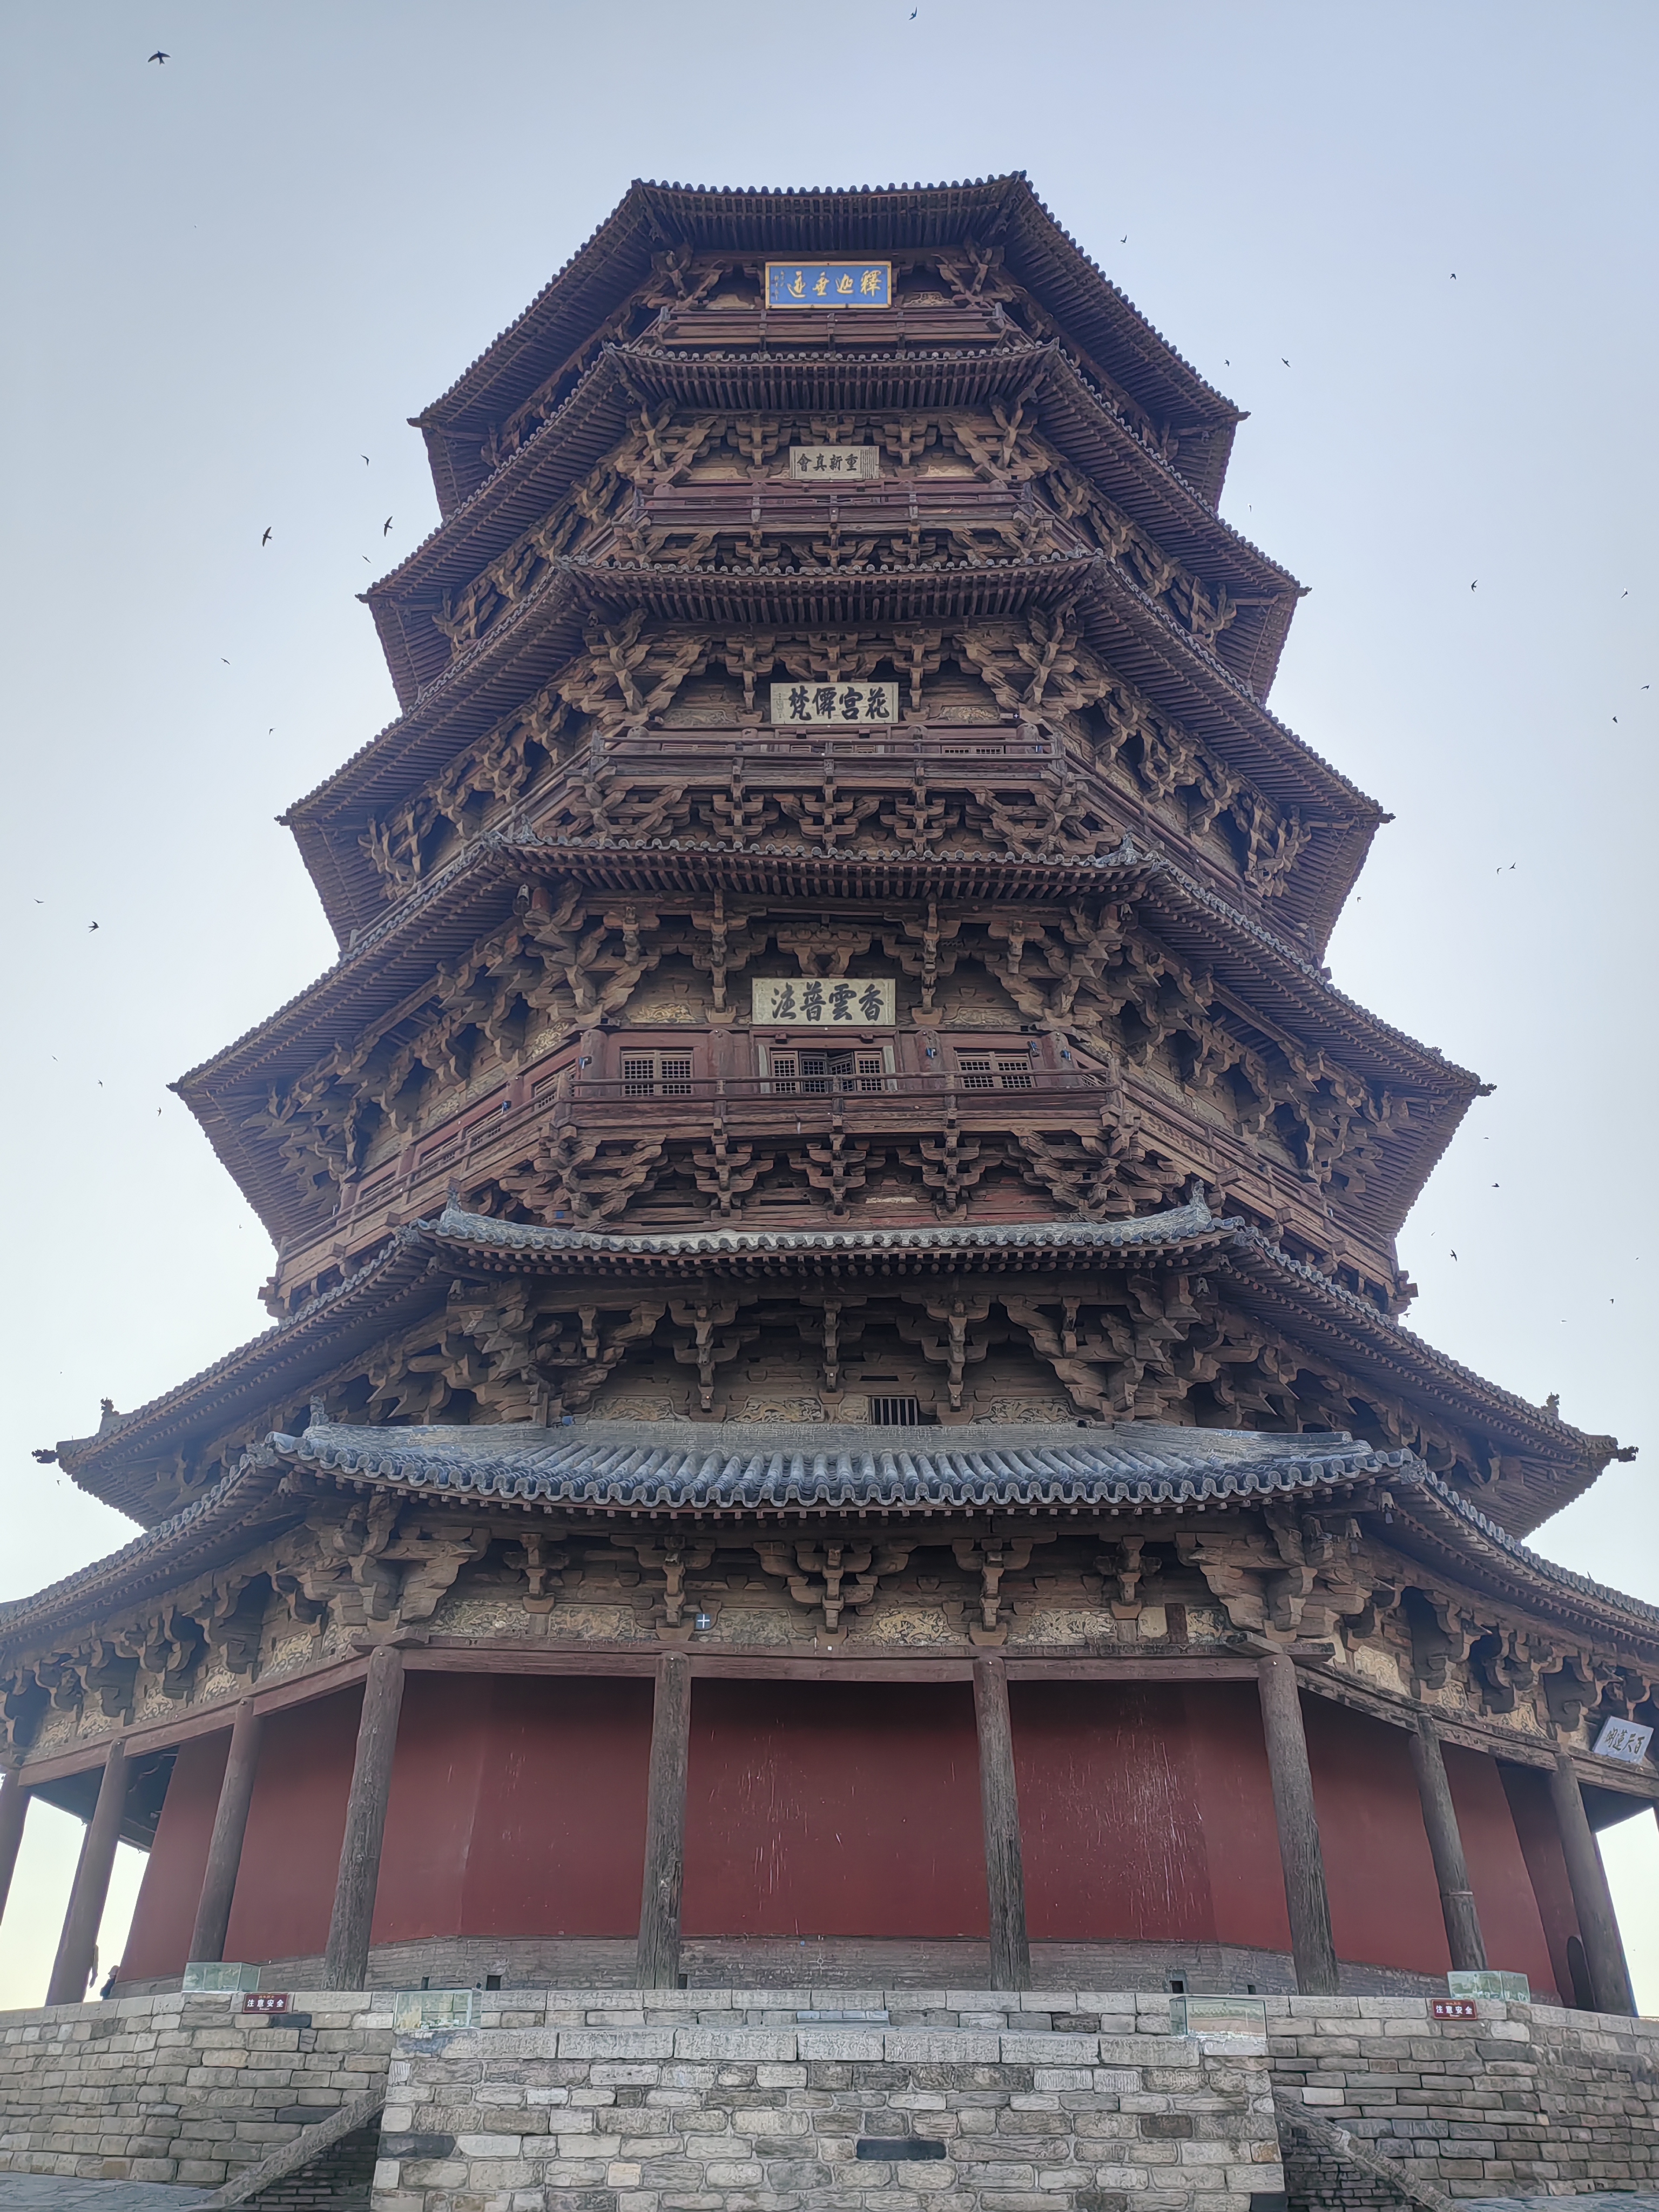
应县木塔输入照片
所以我没有再往画面里塞佛像、月亮或者云海,而是把木塔变成黑白现实锚点,保留原来的仰视关系。背景只留下旧纸色和从建筑红墙提取出来的朱红色。
唯一的巨物,就是一组被放大到不合常理的斗拱。
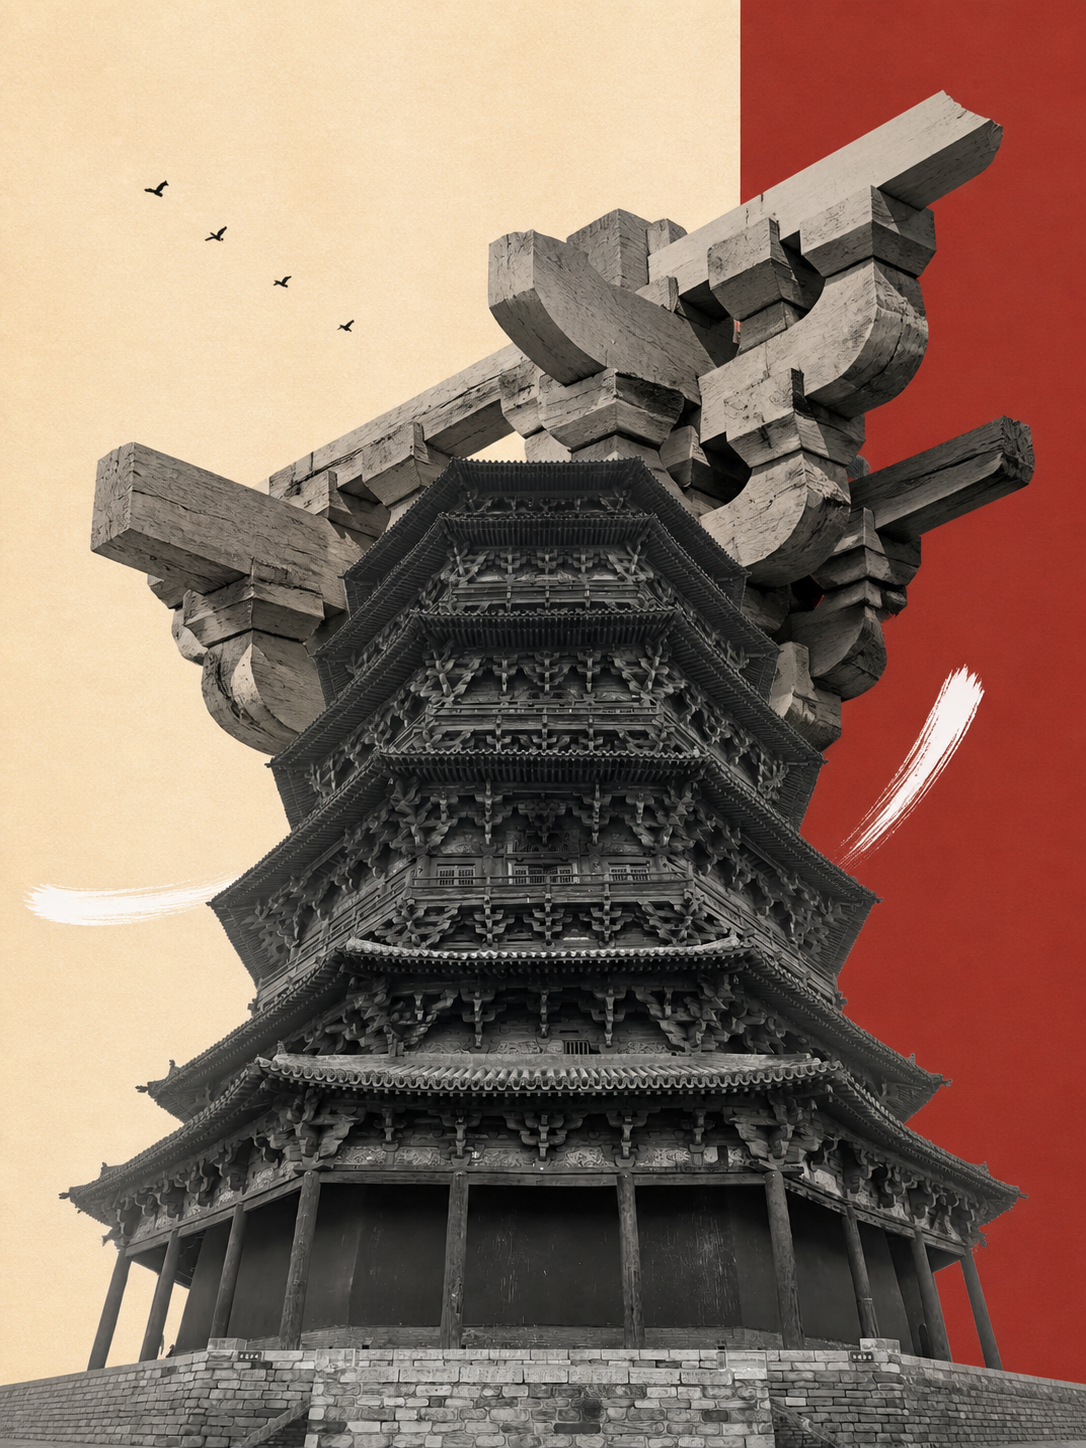
应县木塔超现实拼贴实验
这一张的冲击力最直接。
斗拱本来就是木塔的一部分,被放大以后没有脱离主题,反而把建筑最值得看的结构推到了观众面前。你还是能在三秒内认出应县木塔,但会多停一下,看清它为什么能站在那里。
第二张,佛光寺檐下悬着一口巨钟
第二张是佛光寺东大殿。
这张照片的构图没有木塔那么正。屋檐从左上方一路压向右侧,门、柱、台基都在同一条透视线上。
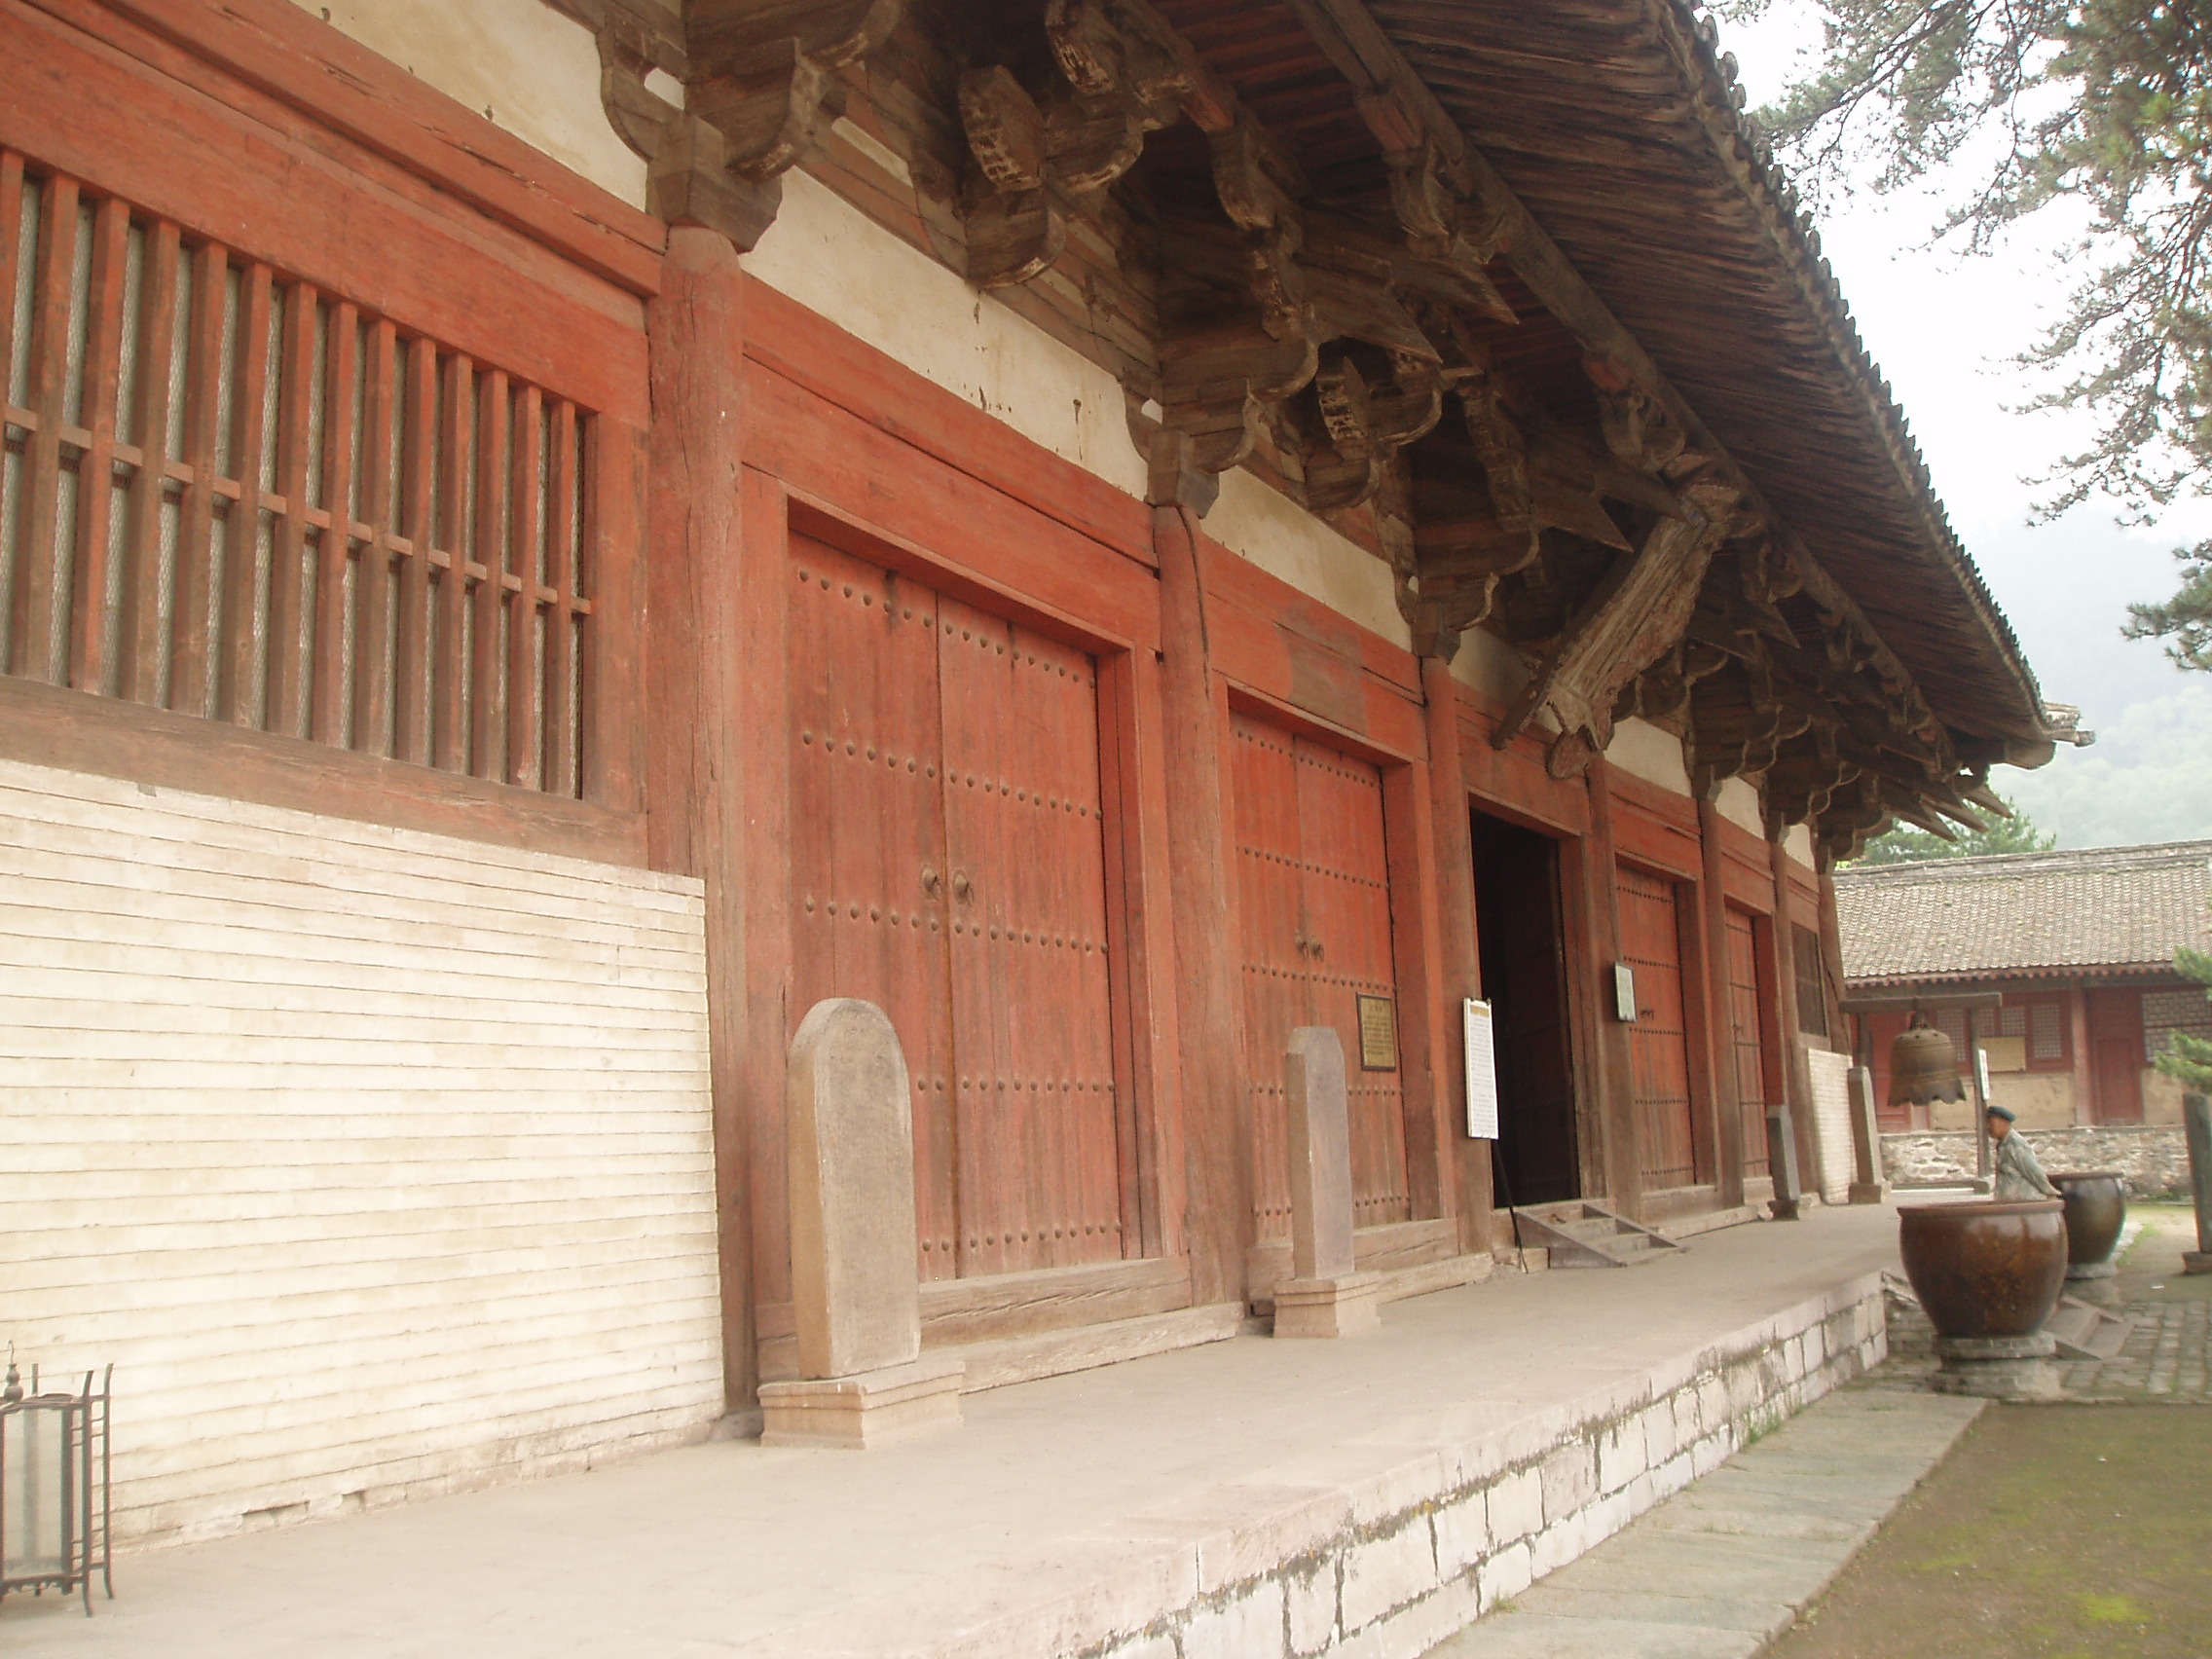
佛光寺东大殿输入照片
我保留了这条斜向动势,把建筑和石碑全部处理成黑白照片。背景颜色也没有照搬上一张,而是从木门、灰瓦和松树里提取出赭黄、朱红与深绿。
唯一新增的巨物是一口古钟,悬在屋檐尽头。
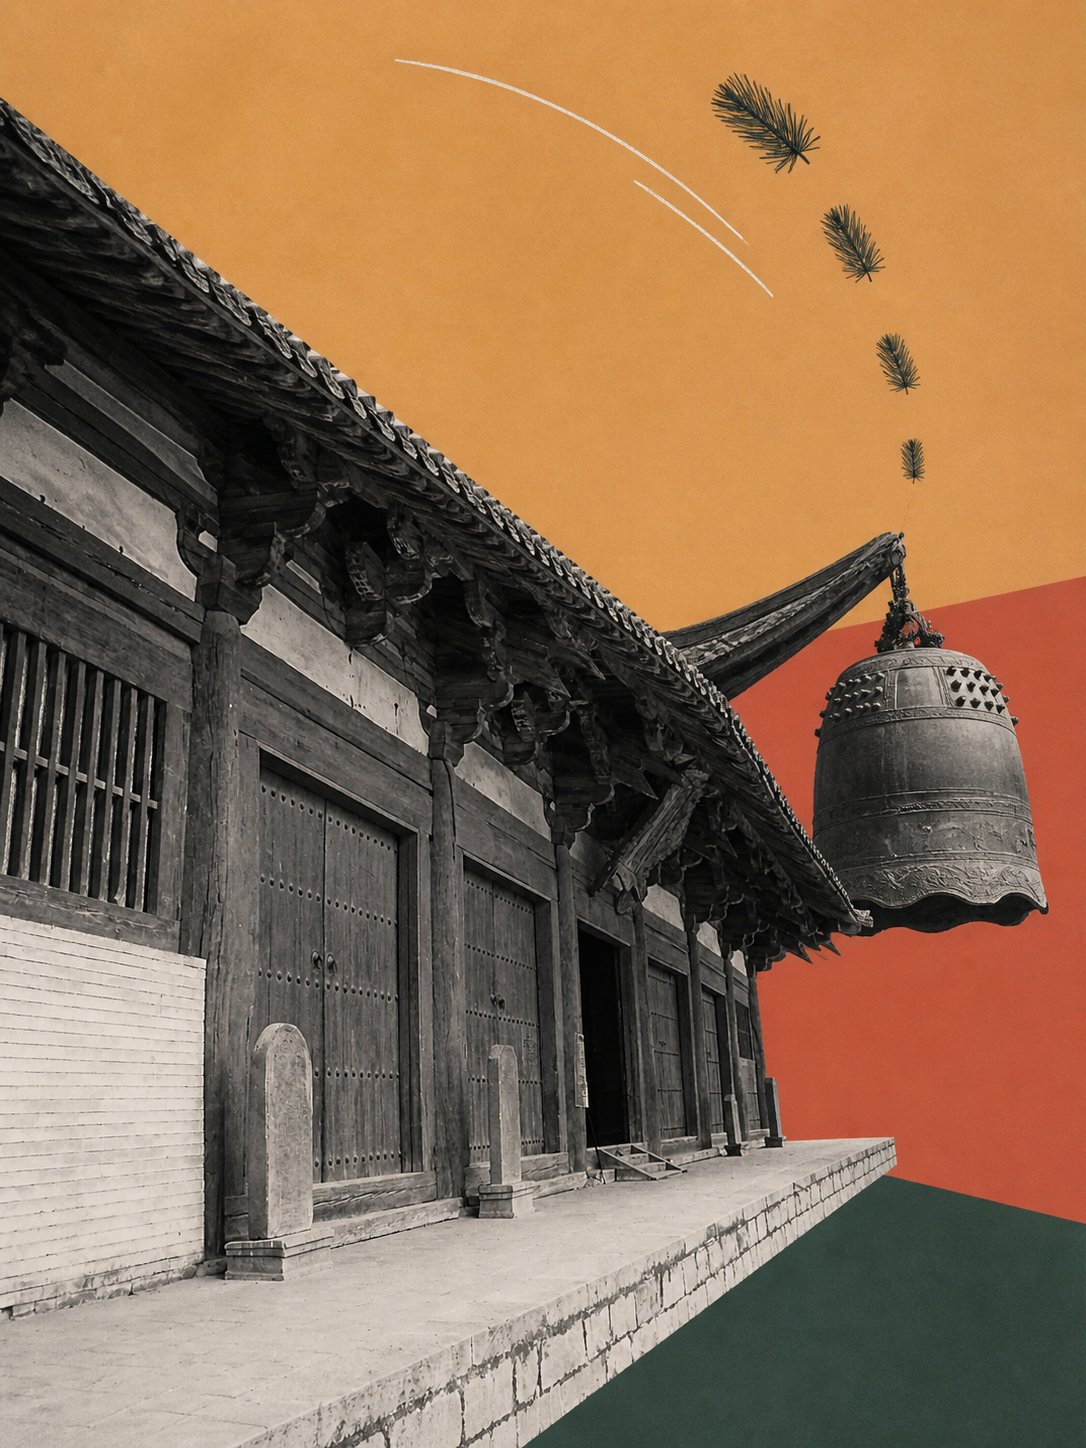
佛光寺东大殿超现实拼贴实验
我最喜欢这一张。
不是因为它最复杂,恰恰是因为它比较克制。屋檐原本就像一条伸出去的手臂,巨钟被挂在末端以后,新的画面关系几乎顺着原照片自己长了出来。
这也是我觉得这个 Skill 最值钱的地方。
它没有替我决定审美,但会不断追问,新加进来的东西和原图到底有没有关系。
第三张,让晋祠的水从桥上升起来
最后一张是晋祠。
原图的入口、桥面和大殿形成一条很强的中轴线,两侧古树把视线收向中央。它最有辨识度的除了建筑,还有水镜台和飞梁的空间关系。
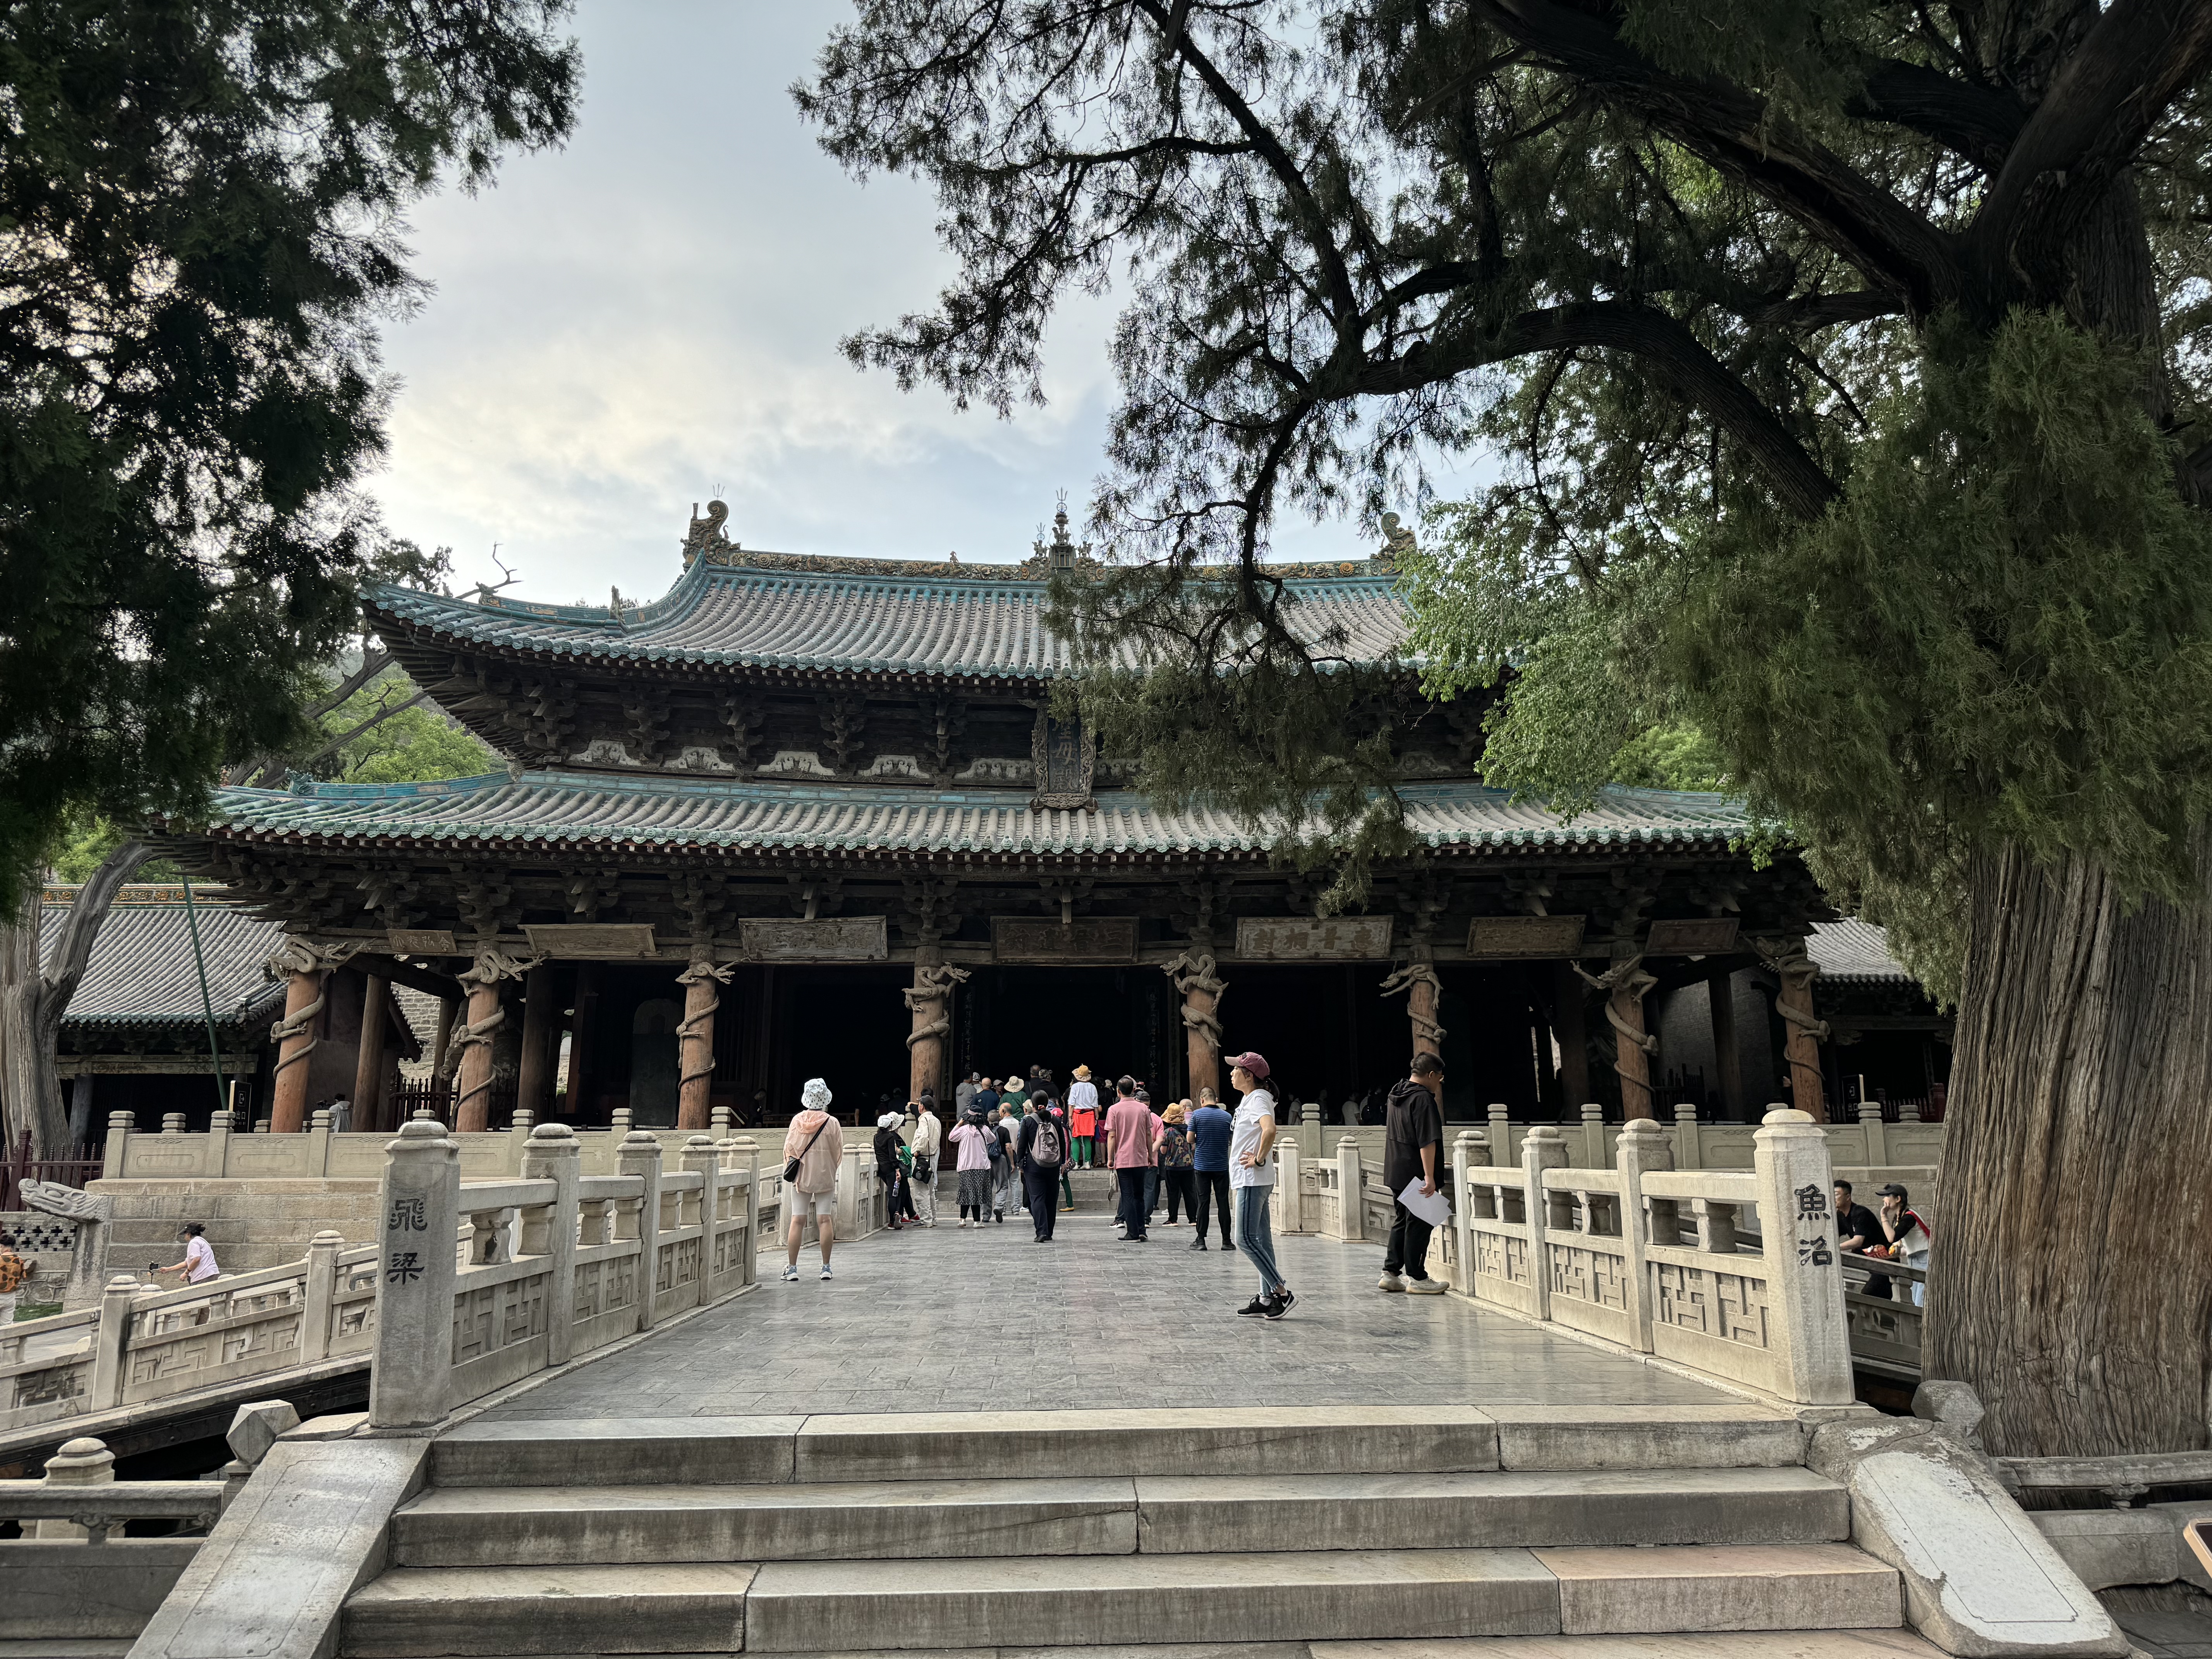
晋祠输入照片
这一次,我把一条蓝色水带从桥面向上抬起,让它穿过建筑中轴,再悬到古树之间。
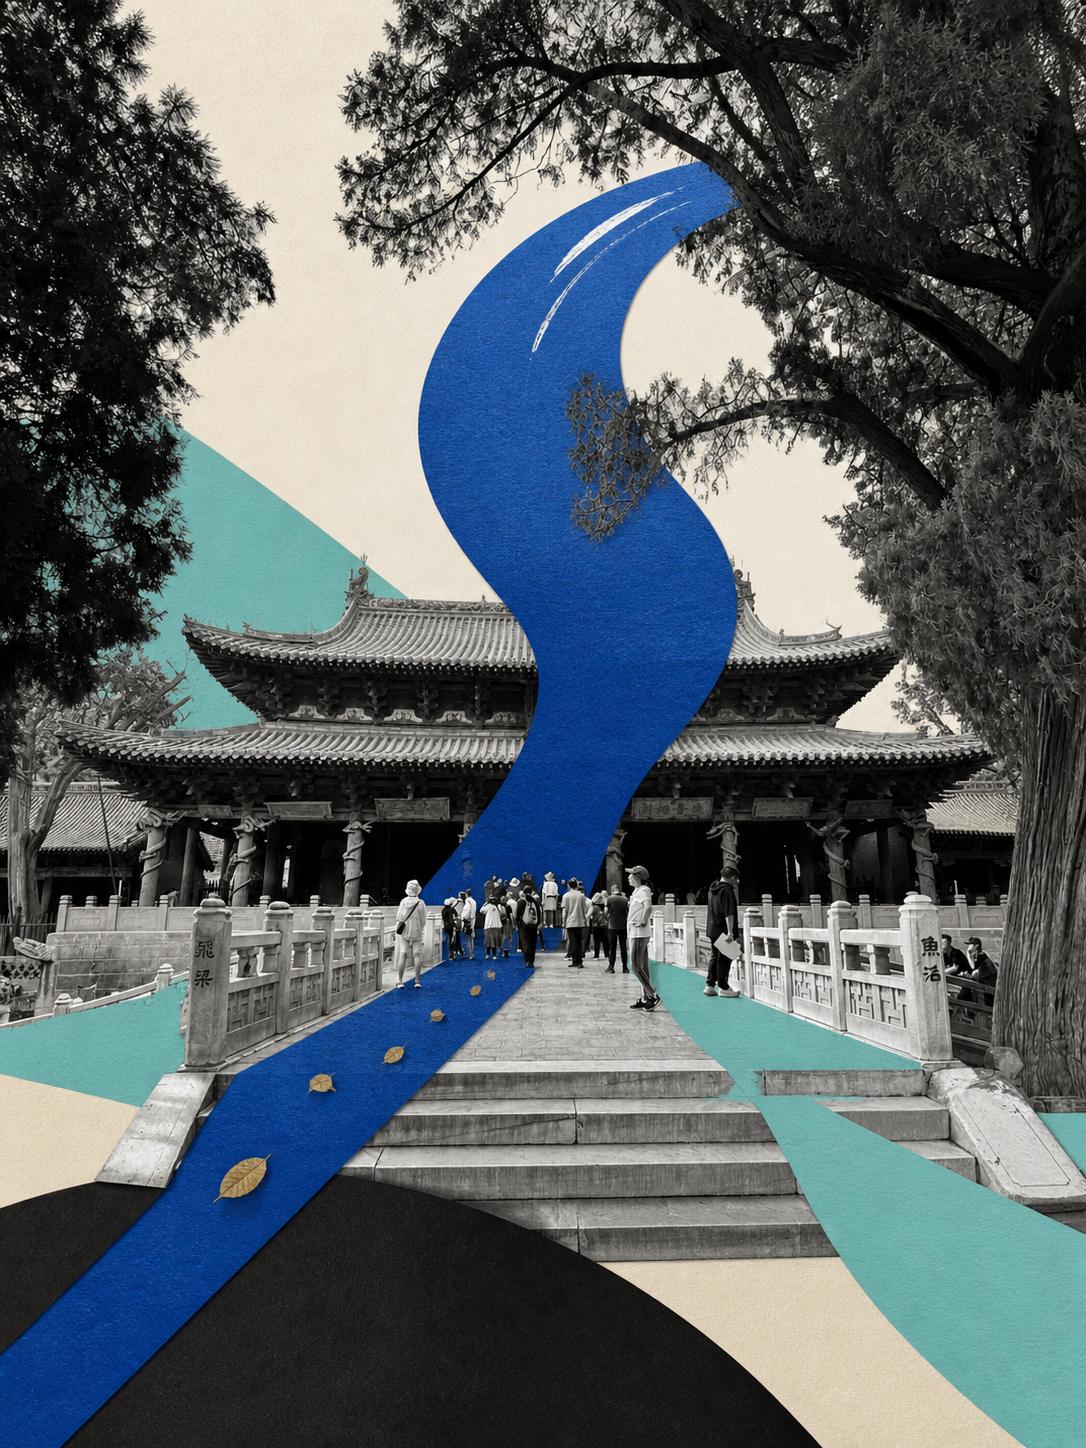
晋祠超现实拼贴实验
结果是三张里最超现实的一张,也最容易失控。
水带、青绿色块、黑色前景和原照片同时出现,信息已经接近上限。它仍然符合只有一个巨物的规则,但也提醒了我,规则正确,不代表每一次执行都会自动变高级。
人还是要负责最后那一下判断。
Skill 真正提供的不是固定画风
连续做完三张以后,我对它的评价比刚看到抖音作品时更明确了。
`surreal-pop-collage` 不是一个按下去就能获得同款海报的按钮。
它更像一张视觉决策清单。先识别照片里什么不能丢,再从原场景里选颜色,接着只允许一个超现实变量进入画面,最后把没有关系的装饰删掉。
木塔最好用斗拱,佛光寺可以用钟,晋祠可以把水变成一条不合常理的视觉路径。
如果换一张城市街景,答案又应该完全不同。
这也解释了为什么很多看起来很完整的 AI 图片,依然让人觉得空。模型负责把每个元素画得都很像,但没人负责决定,哪些东西根本不应该出现。
Skill 能把这个过程写成步骤。
最后的取舍,还是人的工作。