两个刚开源的 Codex 口播视频 Skill,到底自动化了什么
8 月 5 日下午,我在 X 上刷到有人开源了两个 Codex 口播视频 Skill。
一个做 9:16 竖屏数字人口播,一个做 16:9 产品演示加数字人画中画。帖子里说,只需要一张授权照片、产品背景和宣传目标,Codex 就能把脚本、多语言配音、剪映换音色、数字人、字幕和成片串成一条工作流。
这事我挺感兴趣。
因为我最近给 NEXT LAB 做内容时,一直在想视频这件事。图片再好看,也只能停在一个瞬间。真正能把工具过程、界面变化和前后差异讲清楚的,还是视频。
但口播视频又特别麻烦。写稿是一层,配音是一层,数字人是一层,字幕和剪辑又是另一层。每个工具都说自己可以自动化,结果经常是人夹在五个平台中间,手动搬文件。
所以这次我没有只收藏。
我把竖屏版装进了 Codex,然后真的跑了一次项目初始化。
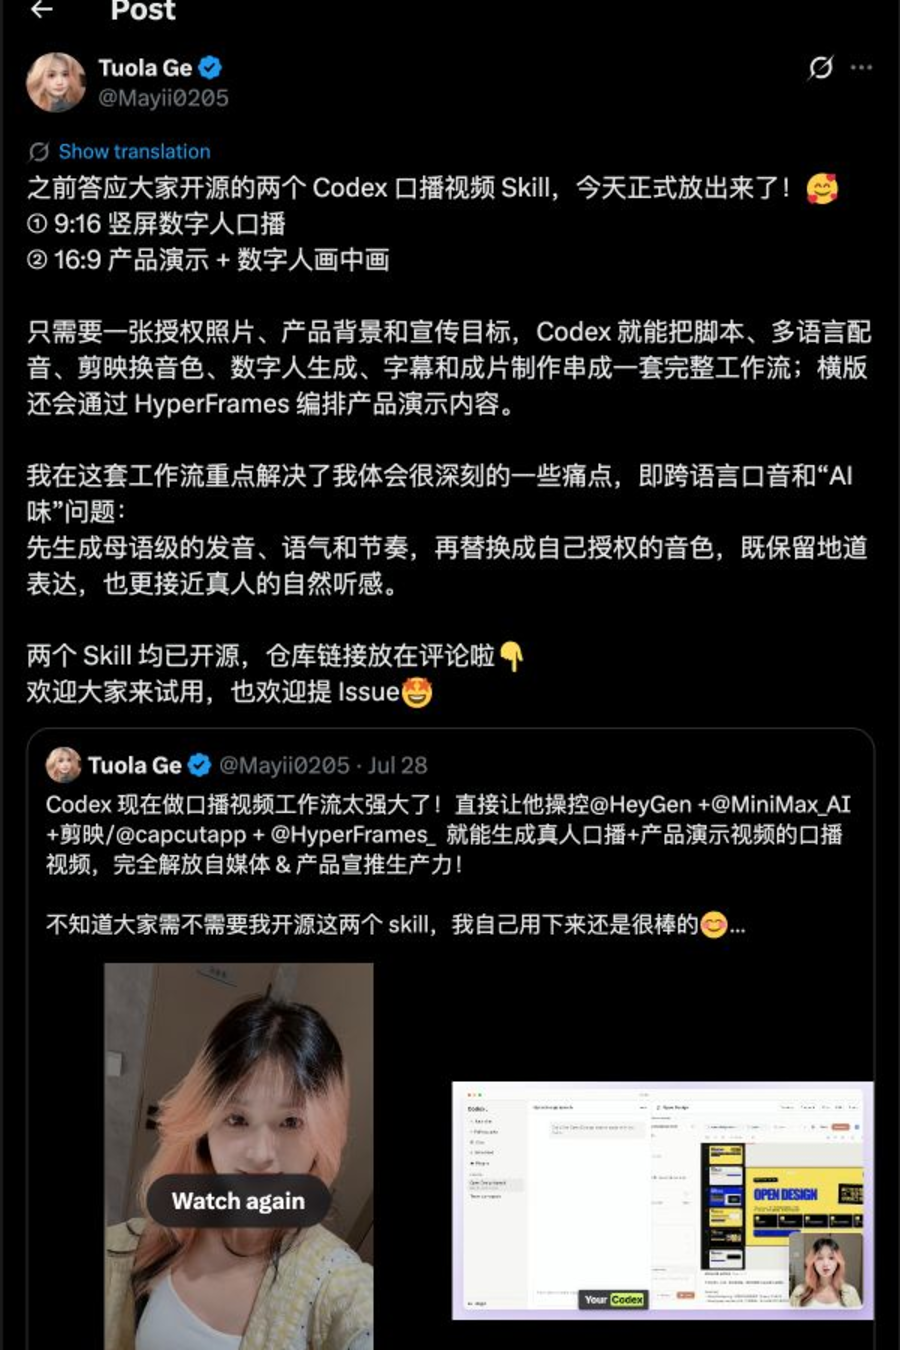
作者发布的两套口播视频 Skill
装完以后,它先让我别急着生成
竖屏版仓库叫 vertical-talking-head-video。安装很直接,把整个目录放进 Codex 的 Skills 目录,重启后就能调用。
我运行它自带的初始化脚本以后,项目里自动出现了输入、四语脚本、音频、数字人、字幕、工作状态和最终输出等目录。与此同时,它还生成了一份 job-state.json,用来记录肖像、音色、脚本和发布授权有没有通过。
我打开这个文件时,里面所有授权状态都是 false。
说真的,这个细节比「一键出片」更让我在意。
它没有一上来就拿照片和声音去调用外部平台,而是先把几件容易被忽略的事拦在前面。照片是不是本人授权,声音能不能使用,脚本有没有确认,视频准备发到哪里。
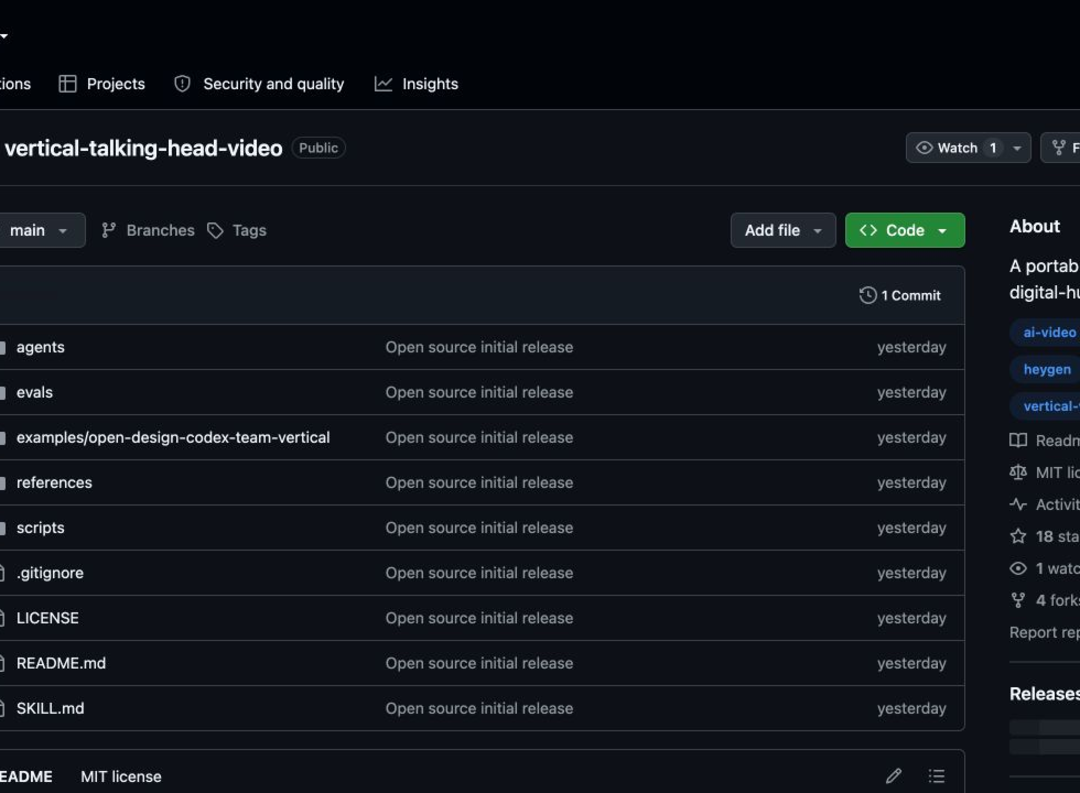
竖屏口播 Skill 仓库
接下来它要求先写中文、英文、日文和西班牙文四个版本。这里不是把中文逐句翻译四遍,而是保留同一套信息和情绪,让每种语言按照自己的口语节奏重新写。
真正生产时,再选其中一种语言做母带。先用 MiniMax 这类服务解决发音和语气,再进剪映或 CapCut 换成已经获得授权的个人音色。
这个思路挺聪明。
直接拿自己的声音去说一门不熟悉的语言,音色可能像,节奏却很容易假。它把「说得像当地人」和「听起来像本人」拆成了两步。
它自动化的不是视频,而是返工顺序
继续往后看,我发现这套 Skill 最严格的地方,是它不允许直接生成完整版数字人。
脚本先确认,音频再确认,肖像检查之后,只做一段 12 到 15 秒的预览。预览里要故意包含快速短语、明显的开口音和情绪重音,用来检查嘴形、牙齿、下巴、眨眼和头部动作。
确认预览没有问题,才生成完整视频。
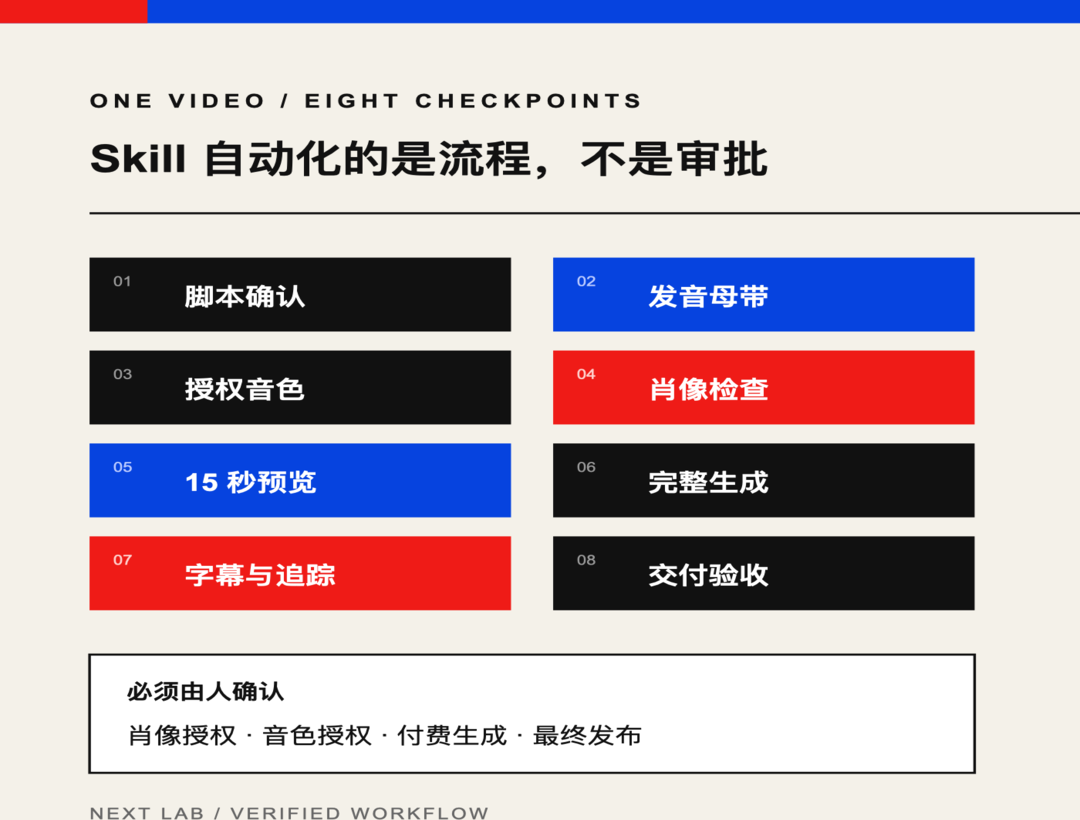
一条口播视频里的八个确认点
刚看到这么多步骤时,我第一反应是,这哪叫自动化,事情不是更多了吗。
但想了一下,这些步骤原本一个都不会消失。区别只是以前它们藏在人的脑子里,往往等四十秒视频全部生成以后,才发现第一个产品名读错了,嘴形太夸张,或者字幕把一句话切得稀碎。
那时候再改,前面的费用和时间一起重来。
这套 Skill 做的事情,是把返工尽量往前挪。能用文本发现的问题,不拖到配音。能用 15 秒发现的问题,不拖到完整生成。能只改字幕的问题,不重新生成数字人。
它更像一个制片流程,而不是一个视频特效。
横屏版更复杂,也更接近产品宣传片
另一个仓库叫 demo-led-talking-head-video。
它不是把竖屏视频横过来,而是把产品演示当成主画面,数字人缩成圆形或圆角方形,放在不遮挡主要操作的位置。产品界面、说明卡片、字幕、数字人和品牌开场,再通过 HyperFrames 组合成 16:9 视频。
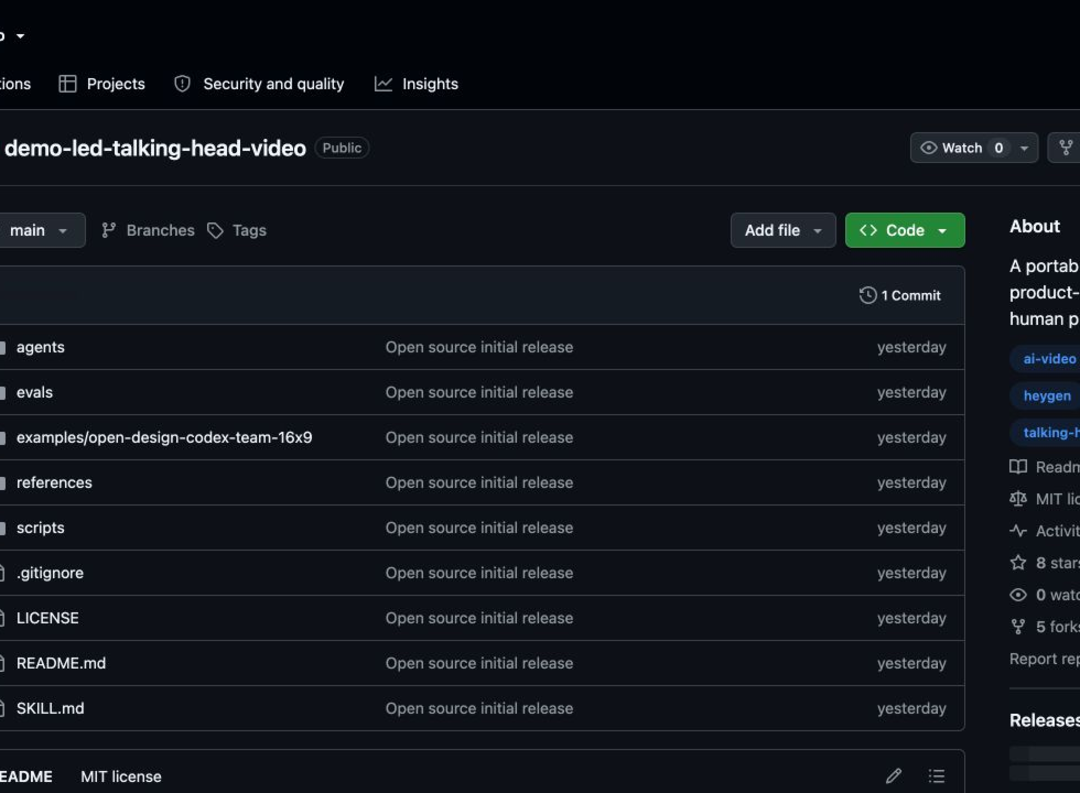
横屏产品演示 Skill 仓库
这个版本有一条规则我很认同。真实产品截图、重新搭建的界面和未来概念演示,必须分开标记。
现在不少 AI 产品视频看起来特别完整,按钮一点,整个工作流丝滑跑完。但你很难知道那是真实录屏,还是为了讲故事重新做的动效。横屏版要求概念功能明确写上 CONCEPT DEMO,不允许把未来能力包装成已经上线。
对于做设计和产品演示的人,这比转场多酷更重要。
不过它的成本也明显更高。除了 HeyGen、MiniMax 和剪映,还要准备真实产品素材、整理分镜、搭建 HyperFrames 场景,再做逐词字幕和最终合成。它不是装完就能凭空产出一条广告片。
至少这次,我没有完整跑到付费生成。
原因也很简单。我没有为这次测试提供一张明确授权用于数字人的肖像,也没有确认要克隆哪段声音。按照 Skill 自己的规则,在这两个授权为空时就应该停下,而不是为了文章效果硬造一个「亲测成功」。
这两个 Skill 值得装吗
如果你只是偶尔做一条口播,用剪映模板可能更快。为了四十秒视频搭一整套多语言、数字人和交付检查,确实有点重。
但如果你要持续做产品更新、海外口播或同一品牌的系列视频,它就开始有价值了。不是因为它能替你按下所有按钮,而是因为第二条、第三条视频不需要重新回忆上次哪里翻过车。
我自己的判断是,先装竖屏版,读一遍它的流程,再决定要不要真的接 HeyGen 和 MiniMax。横屏版适合已经有产品素材,并且愿意认真做分镜的人。
现在很多 Skill 都在比谁更像魔法。
这两个倒有点反过来。它们把魔法拆掉,把一条看似自动生成的视频,还原成脚本、授权、声音、肖像、镜头、字幕和验收。
看起来没有那么爽。
但真要稳定出片,我反而更相信这种不急着生成的 Skill。